De la plăci prajitoare la gazdă activă?
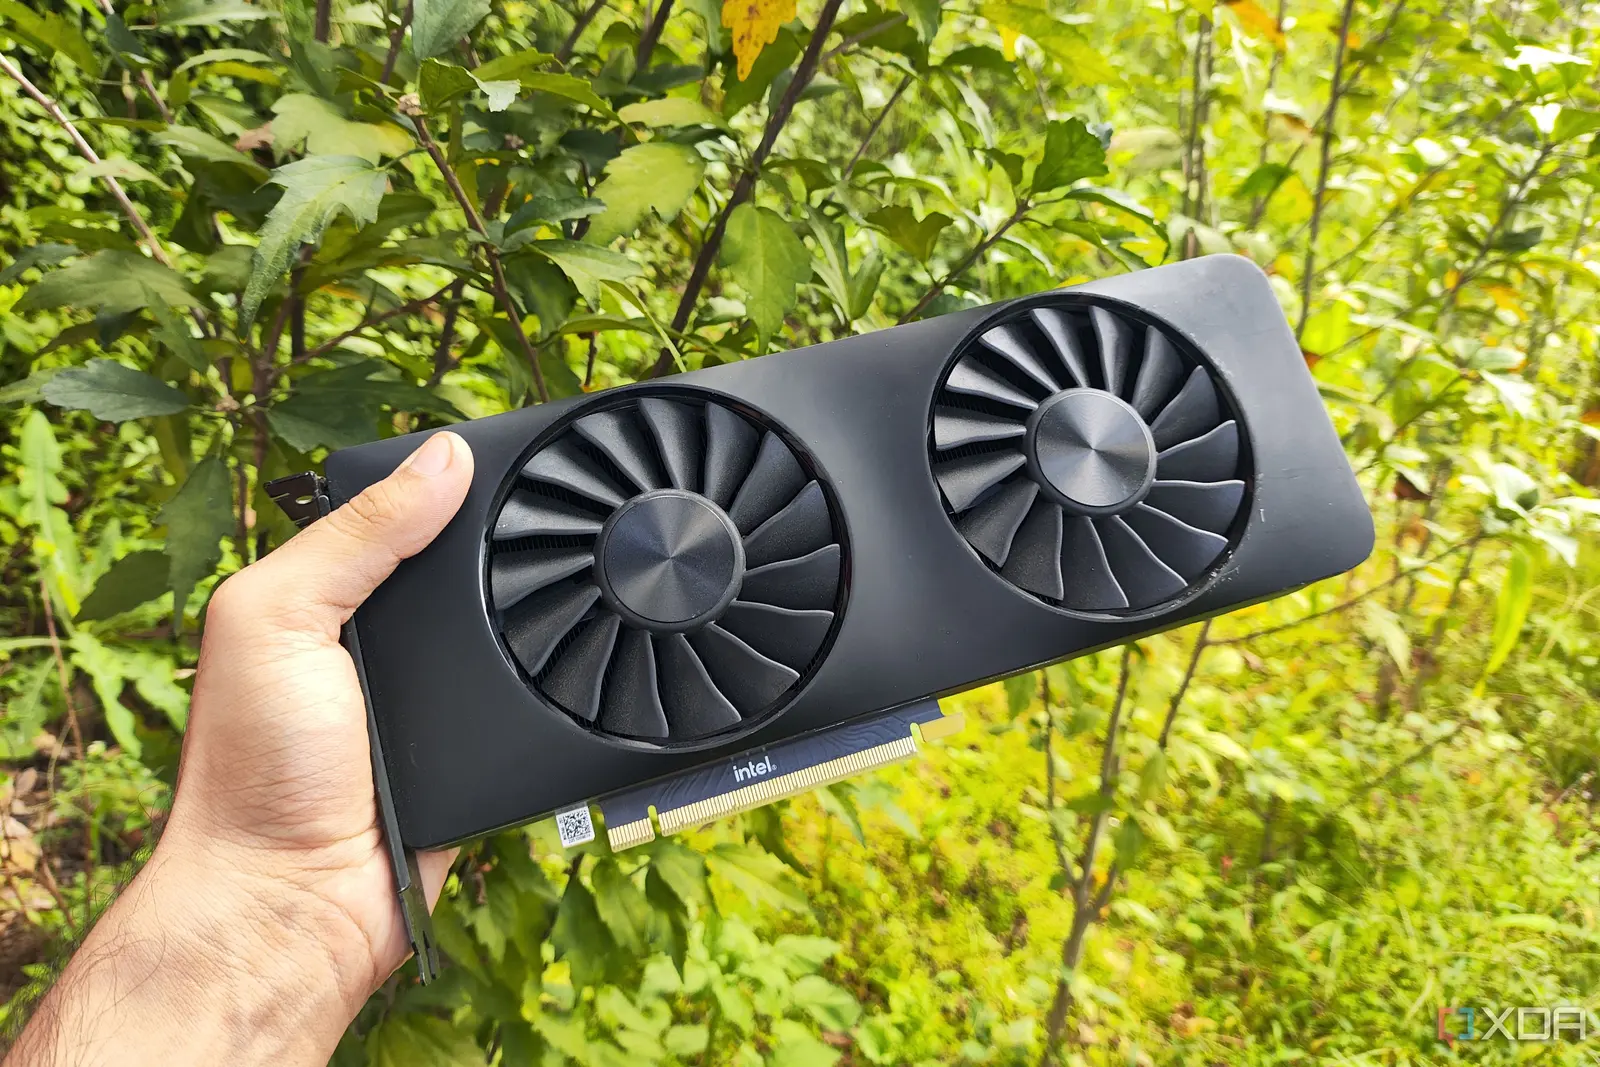
În septembrie 2026, un pasionaț de hardware a descoperit că un Intel Arc A750 lăsat în sertar poate rula modelul Gemma 4 pe un server local cu o viteză surprinzător bună. Experimentul a avut loc într-un laborator casnic modest și nu a costat nimic în afară de placa video însuși.
Culture picks
 AWS devine primul furnizor cloud autorizat pentru datele NATO
 Gigantul editorial C.H.BECK preia controlul startup-ului de AI juridic Noxtua
 Olanda pariază 40 de milioane de euro pe designul cipurilor asistat de AI
 Startup-ul F13 atrage 5 milioane de dolari pentru a revoluționa grafica vectorială cu AI
Autorul avea placa A750 în sertar de ani. A instalat un sistem de operare ușor și un cadru minimal pentru LLM.
Când a pornit Gemma 4, placa a procesat textul mai repede decât se aștepta. Performanța a fost apropiată de cea a unor GPU-uri mai noi și mai scumpe, dar costul a fost zero.
Intel Arc A750 este un GPU de clasă medie pe care mulți utilizatori îl aruncă după câteva săptămâni de jocuri.
Autorul l-a reutilizat instalând un sistem de operare de server cu overhead scăzut și un motor de inferență ușor. A rulat teste de benchmark pe Gemma 4, măsurând trecerea tokenilor și latența. Rezultatele au arătat o generare constantă de tokeni cu 30–40% mai rapidă decât așteptarea inițială.
Largimea de bandă a memoriei și nucleele de calcul au fost suficiente pentru cerințele modelului.
A constatat că stiva de drivere a fost stabilă pe sistemul de operare ales și consumul de energie a rămas sub 150 de watti.
Vale pe să încerci un GPU ieftin pentru LLM?
Nu a fost nevoie de răcire suplimentară în afară de ventilatorul de stoc.
A comparat performanța cu cea a unei NVIDIA RTX 3060 și a găsit că Arc A750 ajunge la viteze în granică de 5% de cel mai puternic GPU.
Acest lucru arată că chiar și GPU-urile mai vechi pot avea valoare pentru sarcini locale de LLM.
Experimentul pune întrebarea: pot hobiiștii și mici afaceri să se bazeze pe GPU-uri vechi pentru sarcini de AI? Pentru modele precum Gemma 4, care se încadrează comod în 8 GB de VRAM, Arc A750 este o alegere excelentă.
Oferă o viteză respectabilă și ține costurile de electricitate la un nivel scăzut. Cu toate acestea, modelele mai mari pot depăși limita de memorie a plăcii, obligând utilizatorii să împartă sarcina sau să facă upgrade.
Autorul subliniază că instalarea a fost simplă.
Nu a fost nevoie de overclocking sau tunaj complex. Performanța GPU-ului a stabilizat după o scurtă perioadă de încălzire, ceea ce o face potrivită pentru inferență continuă.
Întrebări frecvente?
Costul de achiziție — adesea sub 50 de dolari pe piața secundară — o face opțiune atractivă pentru cei care au nevoie de inferență locală fără taxe cloud.
Implicația mai largă este că hardware-ul reciclat poate prelungi viața GPU-urilor mai vechi. Dezvoltatorii pot experimenta cu LLM-uri pe buget, reducând dependența de servicii cloud scumpe. Această abordare reduce și punga de carbon asociată centrurilor de date mari. Când modelele de AI vor crește, va crește și nevoia de soluții de inferență ieftine, iar GPU-urile reprocesate pot deveni un instrument comun în setul de un dezvoltator.
Ce este Gemma 4? Gemma 4 este un model mare de limbaj ușor, proiectat să ruleze eficient pe GPU-uri cu 8 GB de VRAM.
Este conceput pentru inferență locală pe hardware de consum.
Cum se compară Arc A750 cu alte GPU-uri?
Arc A750 oferă o performanță comparabilă cu cea unei NVIDIA RTX 3060 pentru multe sarcini de LLM, dar la un preț mai mic și un consum de energie mai redus.
Este această abordare viabilă pentru modele mai mari? Pentru modele care necesită mai mult de 8 GB de VRAM, Arc A750 va întâmpina dificultăți. Utilizatorii ar putea avea nevoie să împărțască modelul pe mai multe GPU-uri sau să treacă la o placă de performanță mai mare.